Un modèle fonctionne sur une machine de démonstration, mais ses réponses ralentissent dès que plusieurs personnes l’utilisent. Une autre installation accepte un modèle plus volumineux tout en dépassant les moyens d’exploitation disponibles. Le nombre de paramètres et le prix du matériel ne suffisent donc pas à choisir une plateforme.
Le dimensionnement part de la tâche et de la charge. L’équipe définit le modèle envisagé, la longueur du contexte, le délai acceptable et les demandes simultanées. Elle vérifie ensuite que le matériel et le logiciel d’exécution peuvent rendre ce service ensemble.
Relier la mémoire au modèle et à son contexte
Les poids sont les valeurs apprises par le modèle. Leur stockage représente une partie de la mémoire nécessaire. La quantification réduit leur précision numérique, par exemple à quatre bits, pour diminuer cette empreinte. Son effet sur la qualité et la compatibilité doit être évalué avec la version utilisée.
Huit milliards de paramètres stockés sur quatre bits représentent environ quatre milliards d’octets pour les seules valeurs des paramètres. Le format ajoute des informations et le logiciel consomme d’autres ressources. Ce calcul ne fournit donc pas la mémoire totale d’un service opérationnel.
Le contexte, qui comprend les consignes et les informations transmises, demande également de la mémoire. Le cache utilisé pendant la génération et les demandes simultanées peuvent modifier fortement la capacité utile. Un modèle qui tient avec une courte question peut dépasser la mémoire disponible avec plusieurs dossiers longs.
La bande passante mémoire influence le débit, mais le calcul, l’architecture du modèle et le logiciel peuvent devenir limitants. L’essai mesure le délai avant le premier jeton et la vitesse de génération. Les jetons sont les unités de texte traitées par le modèle ; leur nombre ne correspond pas directement au nombre de mots.
Comparer trois profils de machines
Les configurations ci-dessous reprennent trois familles de matériel. Elles illustrent des compromis, sans associer définitivement une profession à une machine. Les schémas montrent des possibilités d’intégration physique ; ils ne définissent pas, à eux seuls, une architecture de production.
Un ordinateur compact à mémoire unifiée
Un Mac mini M4 Pro configuré avec 64 Go partage sa mémoire entre les différents composants. Ce profil peut convenir à des essais ou à un service interne dont la charge reste compatible avec le modèle et le logiciel retenus. Les spécifications Apple permettent de vérifier la configuration exacte.
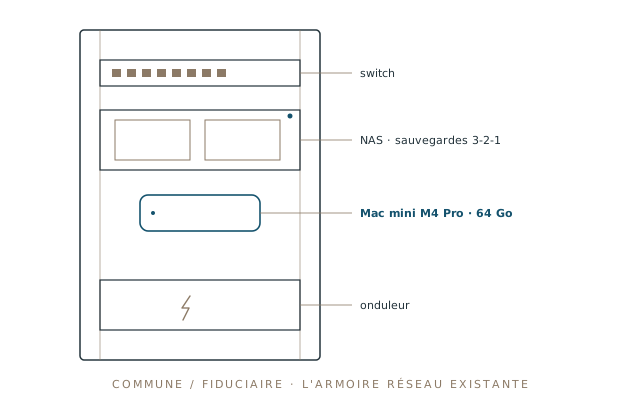
Un assistant documentaire ou un traitement d’extraction peut fournir un cas d’essai. L’équipe teste les formats quantifiés disponibles, la durée des requêtes et leur mise en file d’attente. Les mesures établissent le nombre de requêtes simultanées et la longueur de contexte que la machine peut traiter dans le délai visé.
Une station à forte mémoire unifiée
Le DGX Spark de NVIDIA dispose de 128 Go de mémoire unifiée. Cette capacité permet d’envisager d’autres modèles, mais la mémoire totale n’annonce pas directement leur débit. La compatibilité des outils et les contraintes de l’architecture du processeur font partie de l’essai.
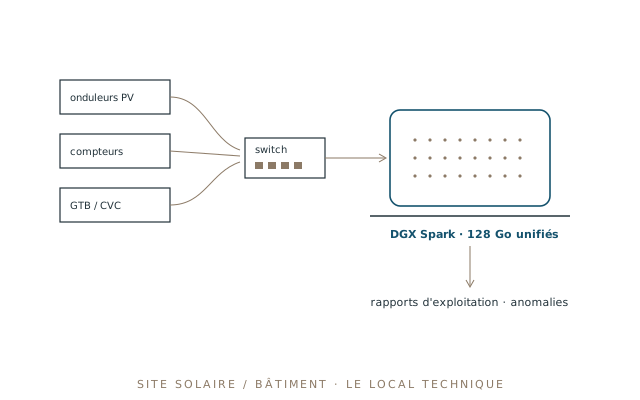
Sur un site industriel, une application peut analyser une copie en lecture seule des données d’exploitation et préparer une explication d’anomalies. L’intégration doit séparer ces traitements du système de commande. Les alarmes opérationnelles et les actions sur l’installation gardent les mécanismes de contrôle retenus pour le site.
Un serveur ou une station avec GPU professionnel
Une RTX PRO 6000 Blackwell offre 96 Go de mémoire sur la carte. Certains modèles d’environ 70 milliards de paramètres peuvent y tenir avec une précision adaptée, en réservant la capacité nécessaire au contexte et à l’exécution. Cette possibilité doit être vérifiée sous la charge prévue.
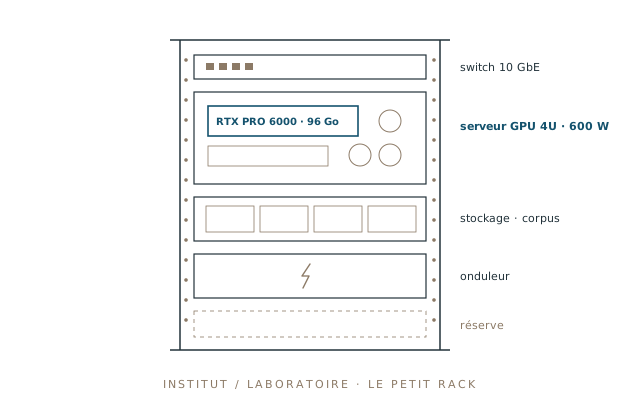
Ce profil peut servir une application partagée, une recherche documentaire exigeante ou des travaux d’adaptation de modèles. La capacité d’entraînement dépend toutefois de la méthode, des paramètres entraînés et des états conservés. Une taille de modèle utilisable en inférence ne constitue pas automatiquement une capacité équivalente d’entraînement.
Le châssis, l’alimentation et le refroidissement doivent correspondre à l’édition de la carte. Une puissance pouvant atteindre 600 W pour le GPU ne décrit pas la consommation de toute la machine. Le bruit et les conditions d’installation comptent également dans un environnement de bureau.
Mesurer le même service sur chaque candidat
L’équipe utilise le même jeu de documents, les mêmes questions et des critères de qualité communs. Elle enregistre le modèle exact, sa quantification, le logiciel et les versions des pilotes. Si une plateforme exige une variante différente, la comparaison doit le signaler.
| Mesure | Raison de la conserver |
|---|---|
| Qualité sur les cas retenus | Vérifier que la vitesse ne masque pas une dégradation des réponses |
| Délai avant le premier jeton | Mesurer l’attente initiale de l’utilisateur |
| Débit et durée totale | Comparer la génération sur des sorties de longueur connue |
| Demandes simultanées | Observer files d’attente, saturation et erreurs |
| Mémoire maximale | Évaluer la marge disponible avec le contexte prévu |
| Consommation et bruit | Préparer le coût et les conditions d’installation |
Un essai peut faire progresser la charge d’un utilisateur vers plusieurs demandes simultanées. L’équipe observe le seuil où le service dépasse le délai acceptable ou refuse des requêtes. Ce seuil aide à choisir une capacité, une file d’attente ou une répartition des traitements.
Une location peut préparer certaines mesures avant l’achat. Elle ne remplace pas le test final lorsque le matériel, les pilotes ou les optimisations diffèrent. Un résultat obtenu sur un GPU de centre de données ne permet pas de déduire sans essai le comportement d’une machine compacte.
Comparer le coût complet et les moyens d’exploitation
Le budget additionne la machine, le stockage, l’alimentation de secours et les équipements nécessaires. Il inclut ensuite l’énergie, l’administration, les mises à jour, l’assistance et la continuité du service. Les devis doivent préciser la date, la devise, les taxes, la garantie et le périmètre de mise en service pour permettre une comparaison.
Les fourchettes de prix non reliées à une configuration datée donnent une précision trompeuse. L’équipe demande donc un devis pour la machine réellement testée et estime son usage sur une durée commune. Elle compare ce coût à la location ou à une API pour une qualité et une disponibilité équivalentes.
Le fonctionnement hors connexion exige également les modèles, les dépendances et les mécanismes d’identité nécessaires. L’installation prévoit la restauration et le remplacement d’un composant défaillant. Une machine performante n’assure pas seule la disponibilité de l’application.
Le choix est justifié lorsque les mesures montrent qu’une configuration répond au service attendu et que l’organisation peut l’exploiter. Les performances annoncées orientent la sélection ; le résultat du test détermine la capacité réellement utilisable.
L’article sur les conditions pour déployer une IA interne présente l’intégration du serveur de modèles aux autres services.